
Physical RSI:Learning to Improve, in the Physical World
让机器人学习新技能的速度不断提高,能够学会的技能也越来越复杂。从每一次真实部署出发,缩短下一项制造步骤的适配周期。
阅读更多 ›让机器人学习新技能的速度不断提高,能够学会的技能也越来越复杂。从每一次真实部署出发,缩短下一项制造步骤的适配周期。
阅读更多 ›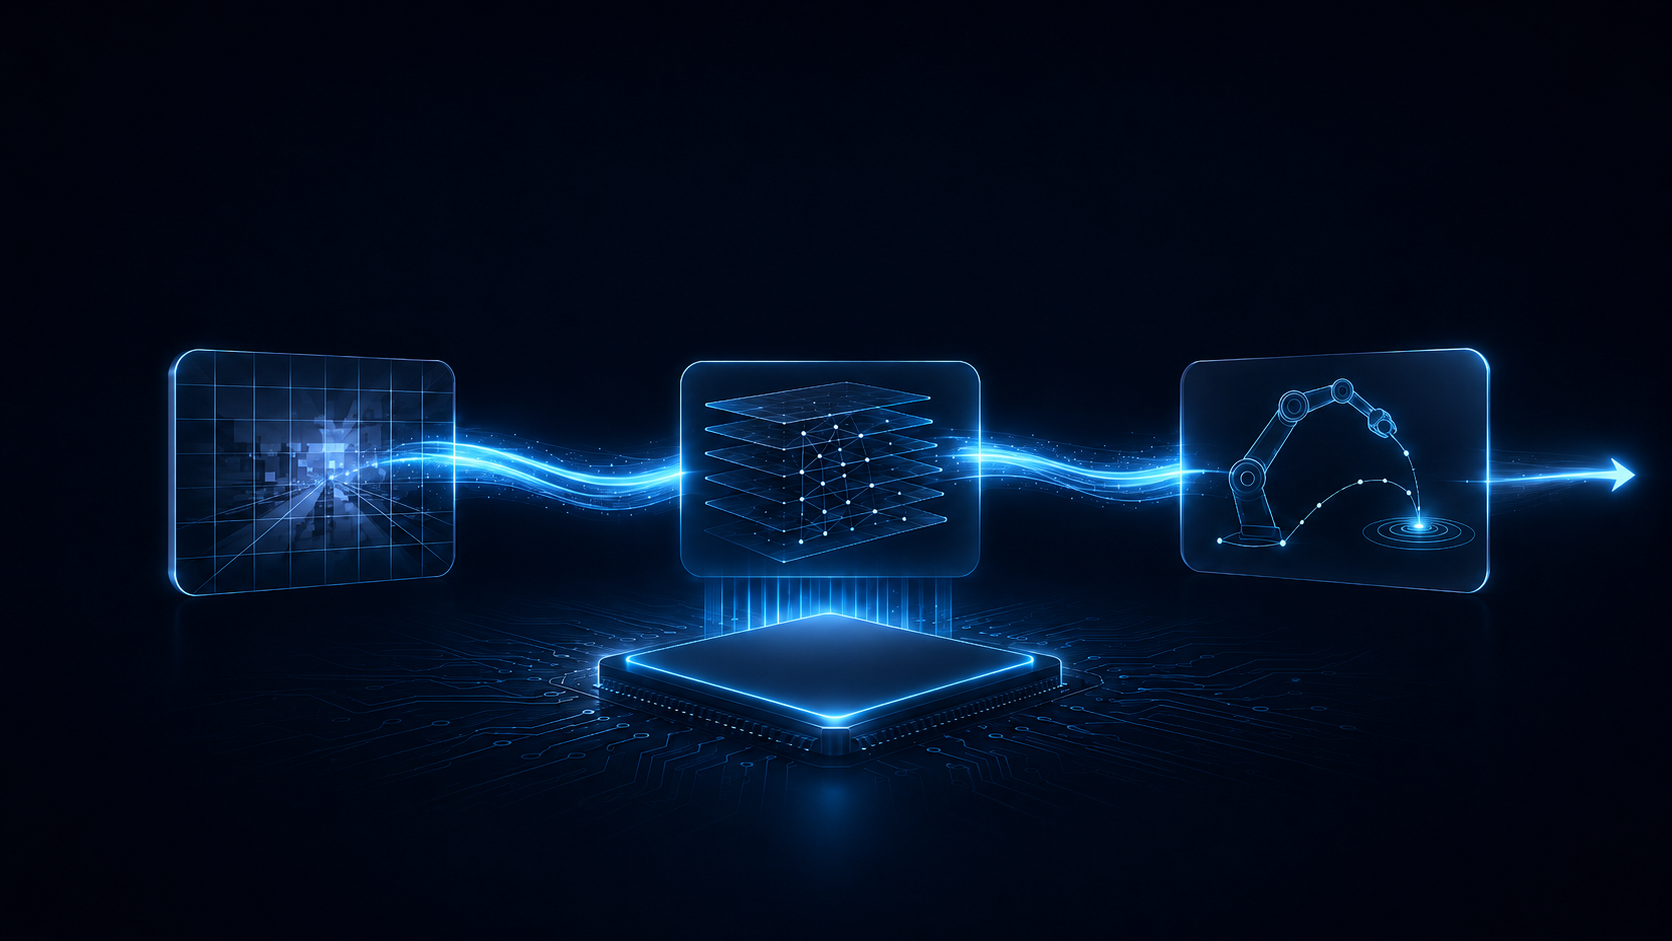
我们提出了一套面向 Physical AI 模型的 Cross-Stack Inference Optimization Framework,通过Framework、Runtime、Kernel 与 Fusion 四个层级的协同优化,实现了4倍推理加速。
阅读更多 ›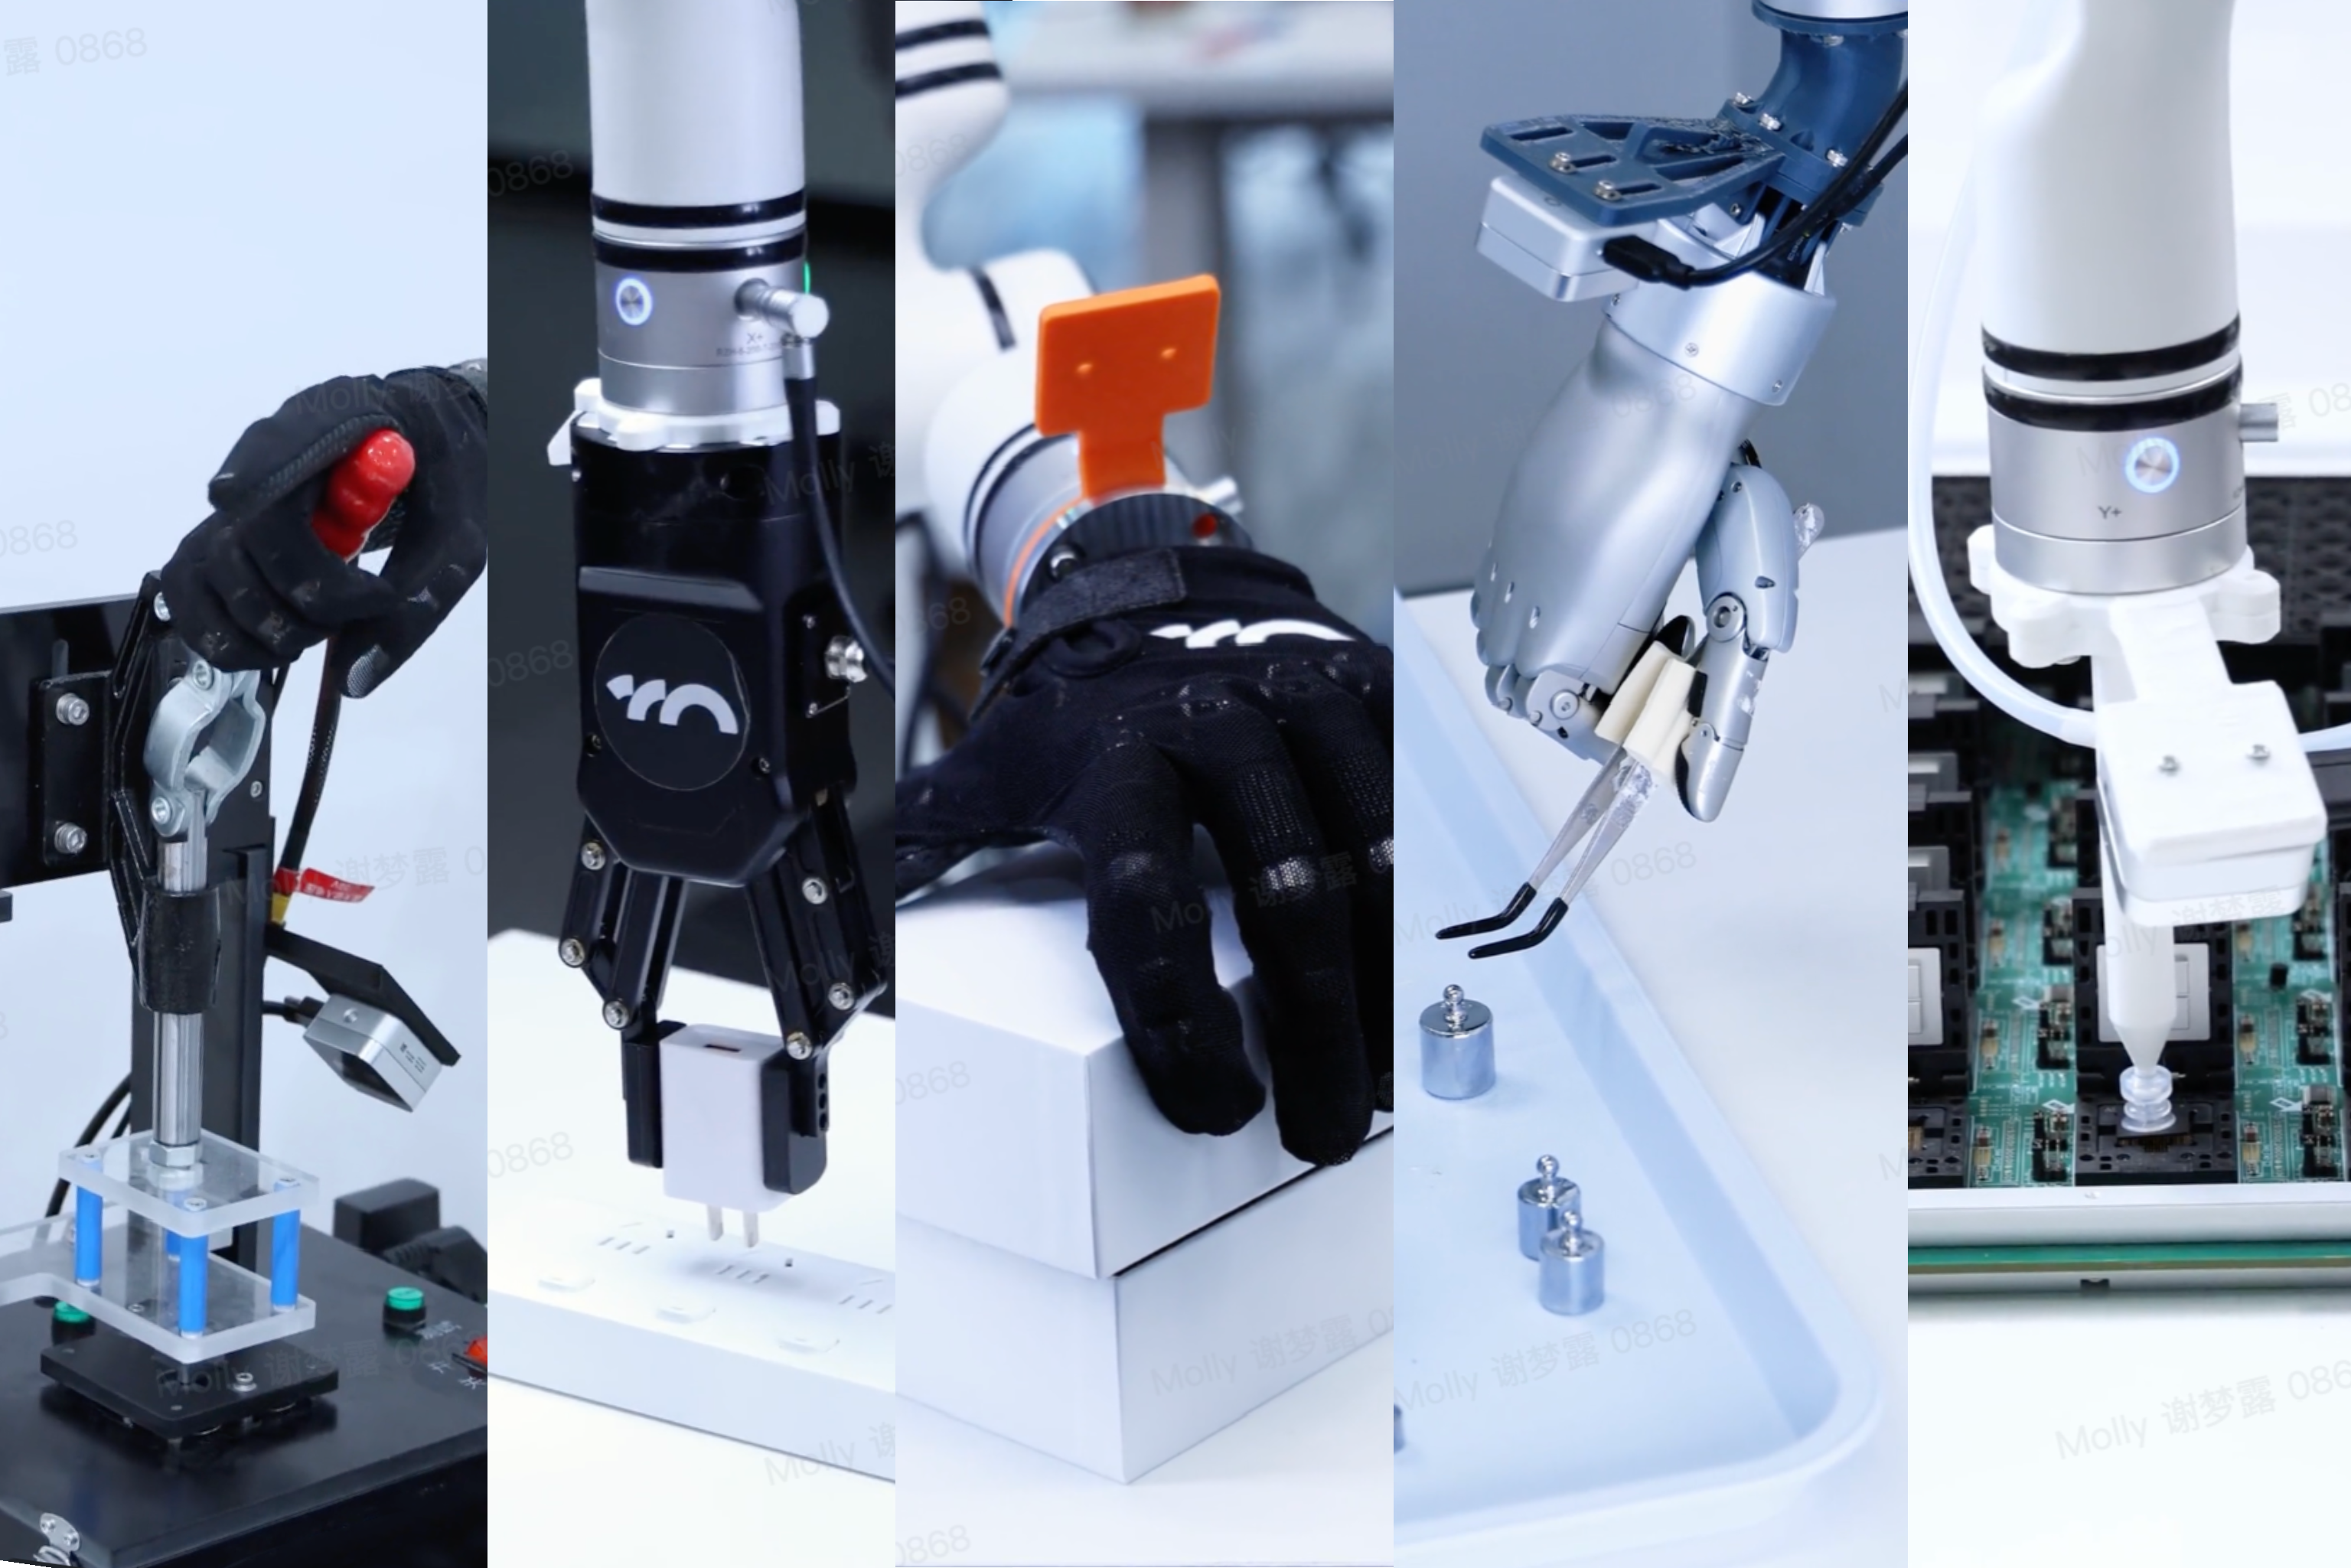
我们构建中的世界奖励模型(WRM)将世界模型的物理理解转化为可迁移奖励信号,统一判断成功、进行中与失败,并与WPM协同减少人工奖励设计和真机试错,推动机器人在真实环境中持续学习与跨任务泛化。
阅读更多 ›