
Physical RSI:
Learning to Improve,
in the Physical World
让机器人学习新技能的速度不断提高,能够学会的技能也越来越复杂。
从每一次真实部署出发,缩短下一项制造步骤的适配周期。
文章目录 · 7 个章节
为什么有了 RL,还需要 Physical RSI?
从“能够执行”到“持续可靠地执行”,机器人还有一道鸿沟需要跨越。预训练与模仿学习提供了起点,但真实部署中的接触变化、物体偏差和失败恢复,需要进一步的经验与适配。我们希望在明确的技能范围内持续提高成功率、速度与鲁棒性,并探索超越人类的表现。
对工业客户而言,智能的重要价值是柔性:
适配一个新的制造步骤,需要多久?
一个策略学会了插拔,不代表换一种连接器、工装或工序后,系统就能快速达标。RL 打开了通过试错改进技能的路径,但如何判断成功、如何复位、在哪里练习、失败后该调整什么,都依赖一整套系统。当这些条件主要由人维护时,新增能力的适配周期就很难持续缩短。研发效率是手段,客户关心的是从提出新需求到可靠上线要等多久。
Physical RSI 的目标,是新技能学得越来越快,能够学会的技能也越来越复杂。让部署经验不仅改善动作,还持续改善评价、训练环境和实验流程,今天解决的问题就有机会帮助系统跨越明天的任务难度。
Physical RSI 延续了 RL、持续学习与元学习的思想。RL 本身也可以学习课程、奖励或元策略;这里的区别在于改进范围和验证方式。我们用 Physical RSI 描述整套系统形成递归改进的组织方式,而不是一种替代 RL 的优化算法。
改善学习系统,也改善物理身体
Self-improvement 是能力变强;recursive self-improvement 是改进反过来增强下一轮改进能力。 多收集一批数据、定期重训模型,尚不足以证明递归改进。我们还需要验证,获得新能力的方法是否因此变得更有效。
我们探索两条并行、可以相互促进的路线。Algorithmic RSI 面向学习系统:自动发现问题、提出假设、设计实验并验证,把有效方法用于下一轮。其改进对象包括策略、评价器、环境、数据选择与训练流程。Embodiment RSI 面向机器人本体:从真实失败中识别物理限制,贯通设计、制造、更换、校准与策略适配,最终进一步改善设计和制造本体的工具与方法。
两条路线分别对应 Auto Research 与 Auto Engineering 的工作性质,但只有成果进一步增强系统自身的改进能力,才构成这里的递归关系。更好的学习系统帮助发现身体瓶颈;更好的身体支持更可靠的操作、更丰富的观测和更高效的实验。
本文主要讨论 Algorithmic RSI。Embodiment RSI 将在后续工作中展开,我们与远图联合提出的超级工站将作为本体迭代的载体。
两套独立的能力分级
以下是本文提出的框架,并非行业标准。AL0–AL3 按学习系统的改进能力分级,EL0–EL3 按能够改进的物理工程范围分级。两者独立评估,并列展示不意味着能力一一对应。
| Algorithmic | 目标 | 能力边界 | Embodiment | 目标 | 能力边界 |
|---|---|---|---|---|---|
| AL0 | 人工主导学习系统迭代 | 人设计评价、课程和训练流程,并决定如何改进;模型在给定流程内学习技能。 | EL0 | 人工主导本体迭代 | 人发现本体限制、提出设计、组织制造和测试;系统提供数据或执行测试。 |
| AL1 | 给定学习框架内的技能优化 | 在人设定的任务、奖励与训练环境中,自动采集交互、更新策略并评估效果,提升成功率、节拍与恢复能力;学习系统的设计与改进仍主要由人负责。 | EL1 | 自主发现本体限制 | 从任务失败与物理测试中识别本体瓶颈,并设计验证实验,区分策略、标定与硬件问题;本体修改与实现仍由人主导。 |
| AL2 | 闭环协同迭代,持续提高跨任务学习效率 | 根据部署失败协同更新策略、评价器和训练环境,完成诊断、干预与验证,积累可复用的学习方法;需通过多轮迭代证明新任务在可比预算下更快达标。 | EL2 | 自主完成本体改进闭环 | 自主诊断并提出设计修改,利用现有工具贯通制造、装配、校准、策略适配与实测验证;设计、制造和测试工具本身基本给定。 |
| AL3 | 扩展学习方法与任务复杂度的边界 | 提出并验证新的学习方法、评价机制或环境生成方法,在持续提高学习效率的同时,学会更复杂的任务。 | EL3 | 递归改进设计与制造体系 | 识别设计、制造或测试工具对本体进步的限制,提出并实施工具与方法的改进,再用升级后的工具制造和验证更好的本体,使本轮改进增强下一轮本体迭代的能力。 |
Algorithmic RSI
人工主导学习系统迭代
人设计评价、课程和训练流程,并决定如何改进;模型在给定流程内学习技能。
给定学习框架内的技能优化
在人设定的任务、奖励与训练环境中,自动采集交互、更新策略并评估效果,提升成功率、节拍与恢复能力;学习系统的设计与改进仍主要由人负责。
闭环协同迭代,持续提高跨任务学习效率
根据部署失败协同更新策略、评价器和训练环境,完成诊断、干预与验证,积累可复用的学习方法;需通过多轮迭代证明新任务在可比预算下更快达标。
扩展学习方法与任务复杂度的边界
提出并验证新的学习方法、评价机制或环境生成方法,在持续提高学习效率的同时,学会更复杂的任务。
Embodiment RSI
人工主导本体迭代
人发现本体限制、提出设计、组织制造和测试;系统提供数据或执行测试。
自主发现本体限制
从任务失败与物理测试中识别本体瓶颈,并设计验证实验,区分策略、标定与硬件问题;本体修改与实现仍由人主导。
自主完成本体改进闭环
自主诊断并提出设计修改,利用现有工具贯通制造、装配、校准、策略适配与实测验证;设计、制造和测试工具本身基本给定。
递归改进设计与制造体系
识别设计、制造或测试工具对本体进步的限制,提出并实施工具与方法的改进,再用升级后的工具制造和验证更好的本体,使本轮改进增强下一轮本体迭代的能力。
学会技能,也改善学习方法
Algorithmic RSI 通过两个相互嵌套的闭环推进。Skill Learning Loop 围绕给定技能完成数据采集与选择、监督学习、强化学习和评估,将示范与试错经验转化为执行能力。具体训练方式随任务选择,闭环不局限于 RL。
Deployment Loop 则用真实部署暴露的问题,更新评价器、训练环境与实验流程,再检验这些改动能否让下一轮技能学习更快、更有效,并适用于新的制造步骤。
我们采用仿真 Env 与少量真机 Env 结合的异步 RL 范式。两类环境异步采集交互经验,供策略学习与评价使用。RimGround 作为仿真环境生成与编辑工具,打造仿真 Env,重点提高噪声与扰动的多样性,以及仿真的运行效率;少量真机 Env 则提供真实物理反馈,用于检验和校准各模块依赖的物理规律与参数,使学习系统持续与真实世界对齐。
三个组件共同支撑这个系统:RimPilot 回答“如何完成任务”,RimCritic 回答“做得怎样,是否接近失败”,RimGround 回答“接下来应该在哪里、练习什么”。RimCritic 指奖励与评价模型,不等同于 actor–critic 算法中的 value critic。
Physical RSI 需要模型与 Harness 共同迭代。我们会持续研发基模,并训练和改进策略、评价等模型能力;阶段性的时间与资源投入会更多集中于技能学习及系统闭环。算法侧 Harness 包括数据流程、训练工具、实验编排、评价与验证机制,其中训练环境的自动生成和编辑是关键:把真实弱点转化为可训练、可复现的条件,再检验真机收益。
在具体场景中,我们已经跑通了 AL1 所对应的技能学习与适配闭环。日冕与远图联合推进的超级工站已展示小时以内的新环境适配能力:据量子位的 WAIC 现场报道,设备在光照与空间布局变化的新环境中,于下午 4:30 通电,经过约半小时训练,在 5:00 完成适配。报道同时介绍了世界奖励模型提供任务反馈、世界策略模型输出动作并回流真实执行经验的机制。(量子位报道,智源社区转载 ↗)
按本文的分级,这为 AL1 的场景落地提供了具体依据:在既定学习框架中,通过交互反馈更新策略并完成适配。在此基础上,当前工作重点是推进 AL2:环境与评价器随策略共同改进,再通过多轮迭代检验新任务能否在可比预算下更快达标。
在单一任务中,挖掘数据多样性
在结构化工业工站中,任务、物体、布局和正常操作流程通常受到约束,常规行为与环境变化所能提供的多样性相对有限。我们的一个心得是:充分利用这样的场景,不仅要积累成功示范,还要主动挖掘 failure data。哪怕只做同一个任务,失败形式也可以多种多样。
以插接为例,同一个目标动作可能因位姿偏差而卡住、因接触力过大而损伤、因打滑而失去对齐,也可能外观看似到位却未导通。这些示意情形暴露了不同的感知、控制、评价或本体限制。对于输出 action、持续改变物理世界的系统,识别失败模式及其发生条件,是理解自身能力的重要部分。
更广义地说,我们关注 boundary data(能力边界数据)。它包括边界附近的失败,也包括勉强成功、失败前兆,以及经过恢复后成功的过程:偏位增大到什么程度开始卡住?接触异常后哪些状态仍能恢复?成功与失败转换附近的差异,往往比反复记录远超能力范围的失败更能帮助诊断。
自动驾驶评价提供了相关证据。环岛研究通过多样化交互行为构建测试空间,自适应生成挑战用例,并在仿真中更有效地覆盖被测系统的失败模式。[5] 另一项工作在切入与无保护左转场景中按挑战程度生成用例,将可重复测试和量化评价落实到仿真与实车。[4] 这些结果支持在有限场景内探索挑战条件与失败模式的评价价值;将它转化为机器人学习收益,仍需真机验证。
我们围绕已发现的失败与边界组织数据采集,在相关位姿、接触、物体属性与扰动条件附近做可重复测试,同时保留成功、失败和恢复轨迹。数据多样性由覆盖了哪些失效机制、边界条件和恢复路径来衡量,而不只看任务数或失败样本数。
同一段经验可以推动多个组件改进:RimPilot 学习动作与恢复,RimCritic 校正判据并识别失败前兆,RimGround 重建困难条件;无法仅靠训练解决的问题进入本体改进流程。值得积累的是边界发现—诊断—干预—验证的完整链条。边界测试帮助诊断,代表性任务测试检验整体表现,两者共同确认收益。
RimCritic:让“如何评价”也从经验中改进
评价决定优化方向。我们希望 RimCritic 识别任务成功、过程进展与可恢复性,并逐步提高对新物体、新条件的适用性。对动作后果和未来状态的建模,有望帮助区分暂时停滞与不可恢复失败;世界模型是否优于直接评价路径,需要由评价质量和策略收益共同验证。
这里展示 RimCritic-Preview-0915 与六个对照模型的离线评价结果。这组实验衡量评价能力,尚不构成真机训练收益或递归改进的证明。
评价指标与聚合口径
- VOC
- 预测进度与时间顺序的秩相关性,主要用于专家轨迹的进度排序。
- VROC
- 倒序输入下的进度排序相关性,同时结合与 VOC 的差距理解方向一致性。
- PRC
- 预测进度与标注进度的秩相关性。
- PRC-minus
- 倒序输入下的 PRC,采用本次评测确认的口径。
- TSA
- 轨迹终态成功判断准确率。
图中另保留 VOC_F1、PRC_F1、AP_PLUS 与 AP_MINUS,沿用实验统计中的指标名称。Bridge + Fractal 对两个子集等权平均;VPB Unseen 对 expert unseen 与 nonexpert unseen 等权平均。全集的 VOC、VROC、VOC_F1 覆盖 8 个评测集,PRC、PRC_MINUS、PRC_F1 覆盖共同有效的 6 个评测集,各子集等权。
VOC、VROC 的解释参考 VLAC,PRC 与 TSA 参考 VPB 公开评价说明。[6][7] 非专家或失败轨迹中的高 VOC 不直接代表更准确的失败识别;需结合反向指标理解。unseen 标签沿用基准划分,不表示已核验各模型训练集的重叠情况。
RimCritic-Preview-0915 · 离线评价
所有雷达图统一使用 −0.5 至 1.0 的径向范围。
Bridge + Fractal
两个子集等权平均 · 9 项指标
VPB Unseen
Expert unseen 与 Nonexpert unseen 等权平均 · OOD 视角
全集
各指标在所有有效评测集上的等权平均
虚线圆环为 0,外圈为 1.0。GVL + Google Gemini 3.8 Flash 的缺失结果按 0 计入;其模型线使用长虚线。缺失值补 0 仅用于本图展示,不代表实测得分为 0。点击图例可显示或隐藏模型,悬停数据点可查看数值。
在本次离线评测的模型与指标范围内,RimCritic-Preview-0915 已达到行业 SOTA 水平,并在部分指标上实现超越。以 VPB Unseen 为例,RimCritic 的 VROC 达到 0.8838,高于对照模型中的最高值 0.6754;在全集上,VROC 达到 0.8662,同样高于对照模型中的最高值 0.7238。后续我们将发布正式的 RimCritic 报告,进一步分析其稳健性优势、效率优势及在不同任务与评测条件下的表现。
正向专家 · 将绿色罐子移到红牛罐旁
预测进度整体跟随标注上升,末端达到约 0.977。视频展示同一训练集案例的未来帧生成能力。
反向数据 · 将橙色物体放到紫色毛巾上
轨迹倒放后,标注与预测进度均从 1 降至 0,展示模型对任务进展方向的区分。
RimCritic · 数据 Scaling 趋势
在这组三档实验中,随着训练数据规模与来源覆盖扩大,RimCritic 在 VPB Expert Seen 和 Unseen 上的 VOC、VROC 与 TSA 均持续提升,呈现出初步的数据 scaling 趋势。
① Bridge:753,507 帧
② Bridge + Fractal:3,274,841 帧
③ Bridge + Fractal + BC-Z + Galaxea Open World:7,694,161 帧
数据规模从约 75 万帧增至 769 万帧时,Unseen 上的 VROC 从 0.545 提升至 0.884,TSA 从 22.2% 提升至 40.1%。我们尤其关注失败与能力边界数据的积累,希望借此进一步增强模型对失败前兆、进度倒退与可恢复性的判断。
横轴为各训练数据集的采样帧数之和,纵轴为指标原值;悬停数据点可查看精确数值。由于 PRC 与 VOC、PRC-minus 与 VROC 接近,此处沿用文档选择展示三个指标。当前实验同时改变了数据规模与组成,尚未单独量化失败数据的增量贡献;三档结果体现已观测到的趋势。
真实结果还需要持续纠正评价,例如以导通检测、力信号或人工核验校正“看起来成功”的误判。当评价器与策略共同更新时,我们会保留独立的外部结果判据和测试集,避免模型分数上涨却没有真实收益。接下来需要验证评价泛化、失败预测,以及接入 RimPilot 后在可比预算下的真机收益。
RimGround:让仿真服务于真实弱点
部署经验决定训练优先级。RimGround 从真机失败与能力边界数据出发,重建相关场景,编辑布局、接触参数、视觉条件与扰动,形成覆盖边界附近成功、失败与恢复条件的课程。
从真实工站到仿真中的持续学习
以我们在华勤远图的真实工作场景照片为起点,下面的示意动画展示了从真实世界转换为虚拟仿真环境,再在仿真中持续学习的流程。
从真实照片到可训练的仿真环境
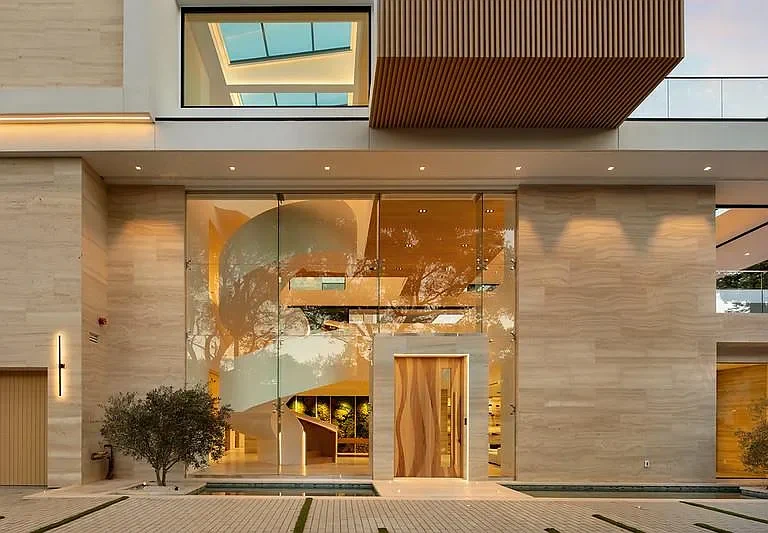
从真实照片出发,快速重建空间、生成三维资产并组织成可编辑场景,正在成为越来越成熟的技术路径。我们看重的是这类方法向不同物体、布局与工作场景迁移的潜力:以现场资料为输入,缩短新环境的构建周期,让仿真能够跟上真实部署中不断出现的新条件。下面的照片与视频提供了几个直观样例,展示这条路径在不同场景中的形态。
照片到三维场景 · 空间重建样例
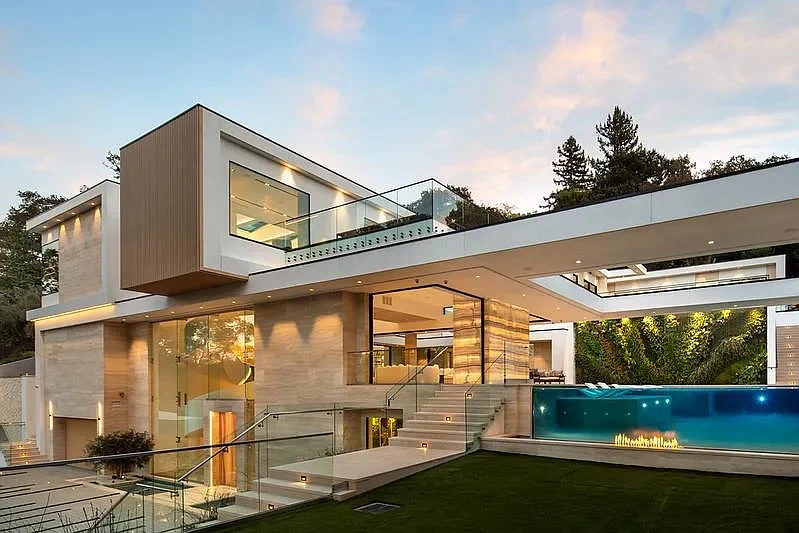
查看另一张参考照片:建筑入口
播放查看由参考照片重建的三维空间。
参考图原帖 ↗ · 模型演示原帖 ↗ · Tripo 案例页 ↗
这些样例展示场景重建的技术基础;面向机器人学习,我们还会在此基础上接入物理交互、任务定义与真机校准。视频需联网播放。
RimGround:构建面向持续学习的场景生成工作流
我们将基于这些逐渐成熟的重建与生成技术,构建上方华勤远图工作场景动画所描述的工作流:从真实工站照片与部署经验出发,生成可训练、可编辑的仿真环境,围绕失败与能力边界持续组织训练,再回到真机检验收益。这也是图 03 所描述的闭环。以插接工站为例,我们会把工作台与工装的多视角照片、连接器尺寸和失败轨迹转化为场景输入,并将影响成败的因素组织成可控制、可复现的环境变量。
- 重建与校准:分离工作台、工装、连接器和障碍物,对齐坐标系与实测尺度;遮挡区域、接触面和插孔几何需由补拍、测量或 CAD 约束。
- 补齐物理交互:配置碰撞体、质量、摩擦、关节与接触参数,接入机器人动作、观测、成功判据及复位逻辑;通过实测反馈校准关键参数。
- 围绕失败编辑课程:改变连接器偏位、工装偏差、遮挡、光照和摩擦条件,构造覆盖成功、卡滞与恢复的场景族,并保留可复现的参数记录。
- 用真机收益筛选:在可比训练预算下检验新增场景能否改善成功率与恢复能力,把有效的场景编辑方法积累给后续任务。
复现失败机制比视觉相似更关键。 场景需要在关键物理条件下复现相应困难,才有机会帮助解决部署问题。在相同训练预算下,生成环境是否提升真实成功率、恢复能力与鲁棒性,是课程价值的最终检验。
递归目标是改善课程选择方法。积累“什么失败适合什么训练干预”的经验,才能让后续环境生成与编辑更有效。在仿真与真机结合的异步 RL 中,RimGround 提高仿真 Env 的噪声多样性和运行效率,少量真机 Env 持续提供物理规律与参数的校准反馈,并承担真实效果验证。环境生成本身无法消除真实复位、磨损和实验吞吐量的限制。
从工业技能,走向物理实验与本体改进
工业是我们的第一验证环境。我们优先选择线缆、插拔等边界清楚、结果可验证、可以反复试验的场景,先把特定技能做得可靠、高效,再检验切换物体、工装与制造步骤时的适配周期能否持续缩短。以高质量 atomic skills 对接上层任务编排,客户获得可用的机器人技能与系统,Physical RSI 则支撑持续交付。
实验室是第二验证域。我们将探索评价、环境构建与技能学习流程能否迁移到物理实验,而不是预设工业经验天然通用。Embodiment RSI 是并行探索的另一条路线:后续以与远图联合提出的超级工站为载体,从可更换末端等边界明确的改动开始,验证本体改进是否同时改善任务表现与后续学习效率。
我们会在相同可靠性门槛和可比预算下,检验这些经验能否让未参与优化的新任务更快达标,并在多轮迭代中持续缩短适配时间、降低交互与人工成本。同时,以接触精度、操作步骤和恢复要求等具体维度衡量任务复杂度,验证能力范围是否真正扩大,让离线评价的改进最终落实为可重复的真机收益。
每一次部署,都应为下一项能力的获得,
留下可复用的经验。
Physical RSI 的长期价值,将体现在新技能能否学得越来越快、能够学会的技能能否越来越复杂,并最终转化为工业客户更短的新工序适配周期。
参考资料
- Generalist — Towards Machines with a Thousand Hands ↗
2026 · 多末端训练与模型适配。
- General Robotics — Introducing Auto Engineering for Robotics ↗
2026 · 自动化工程闭环,其 Auto Engineering 含义比本文本体方向更宽。
- The Ingredients of Real-World Robotic Reinforcement Learning ↗
2020 · 真实机器人自主学习的奖励、感知与复位问题。
- The Implementation of Safety Acceptance Evaluation for Highly Automated Vehicles ↗
X. Wang, T. Wang, S. Xu, Y. Zhong, H. Peng. 2023 · International Journal of Automotive Engineering, 14(3), 58–65.
- Comprehensive Safety Evaluation of Highly Automated Vehicles at the Roundabout Scenario ↗
X. Wang, S. Zhang, H. Peng. 2022 · IEEE T-ITS, 23(11), 20873–20888.
- VLAC: A Vision-Language-Action-Critic Model for Robotic Real-World Reinforcement Learning ↗
2025 · VOC、VROC 的定义及解释。
- VLAC-Cut — Evaluating on Video Progress Benchmark ↗
公开评测说明 · PRC、VOC 与终态成功评价;本次内部评测的具体实现需独立确认。